Bisher konnte der Prozessor rechnen und der Arbeitsspeicher nichts weiter als Bits zu halten. Diese Arbeitsteilung steckte seit Jahrzehnten in der Von-Neumann-Architektur, und bei künstlicher Intelligenz wurde sie zum Flaschenhals. Ein neuronales Netz besteht aus Milliarden von Multiply-Accumulate-Operationen, und für jede einzelne wandern Zahlen zwischen Speicher und Recheneinheit. Bis zu 90 Prozent dieser Energie fließen in den Transport statt ins Rechnen. In der Informatik nennen wir dies die Grenze, die Memory Wall.
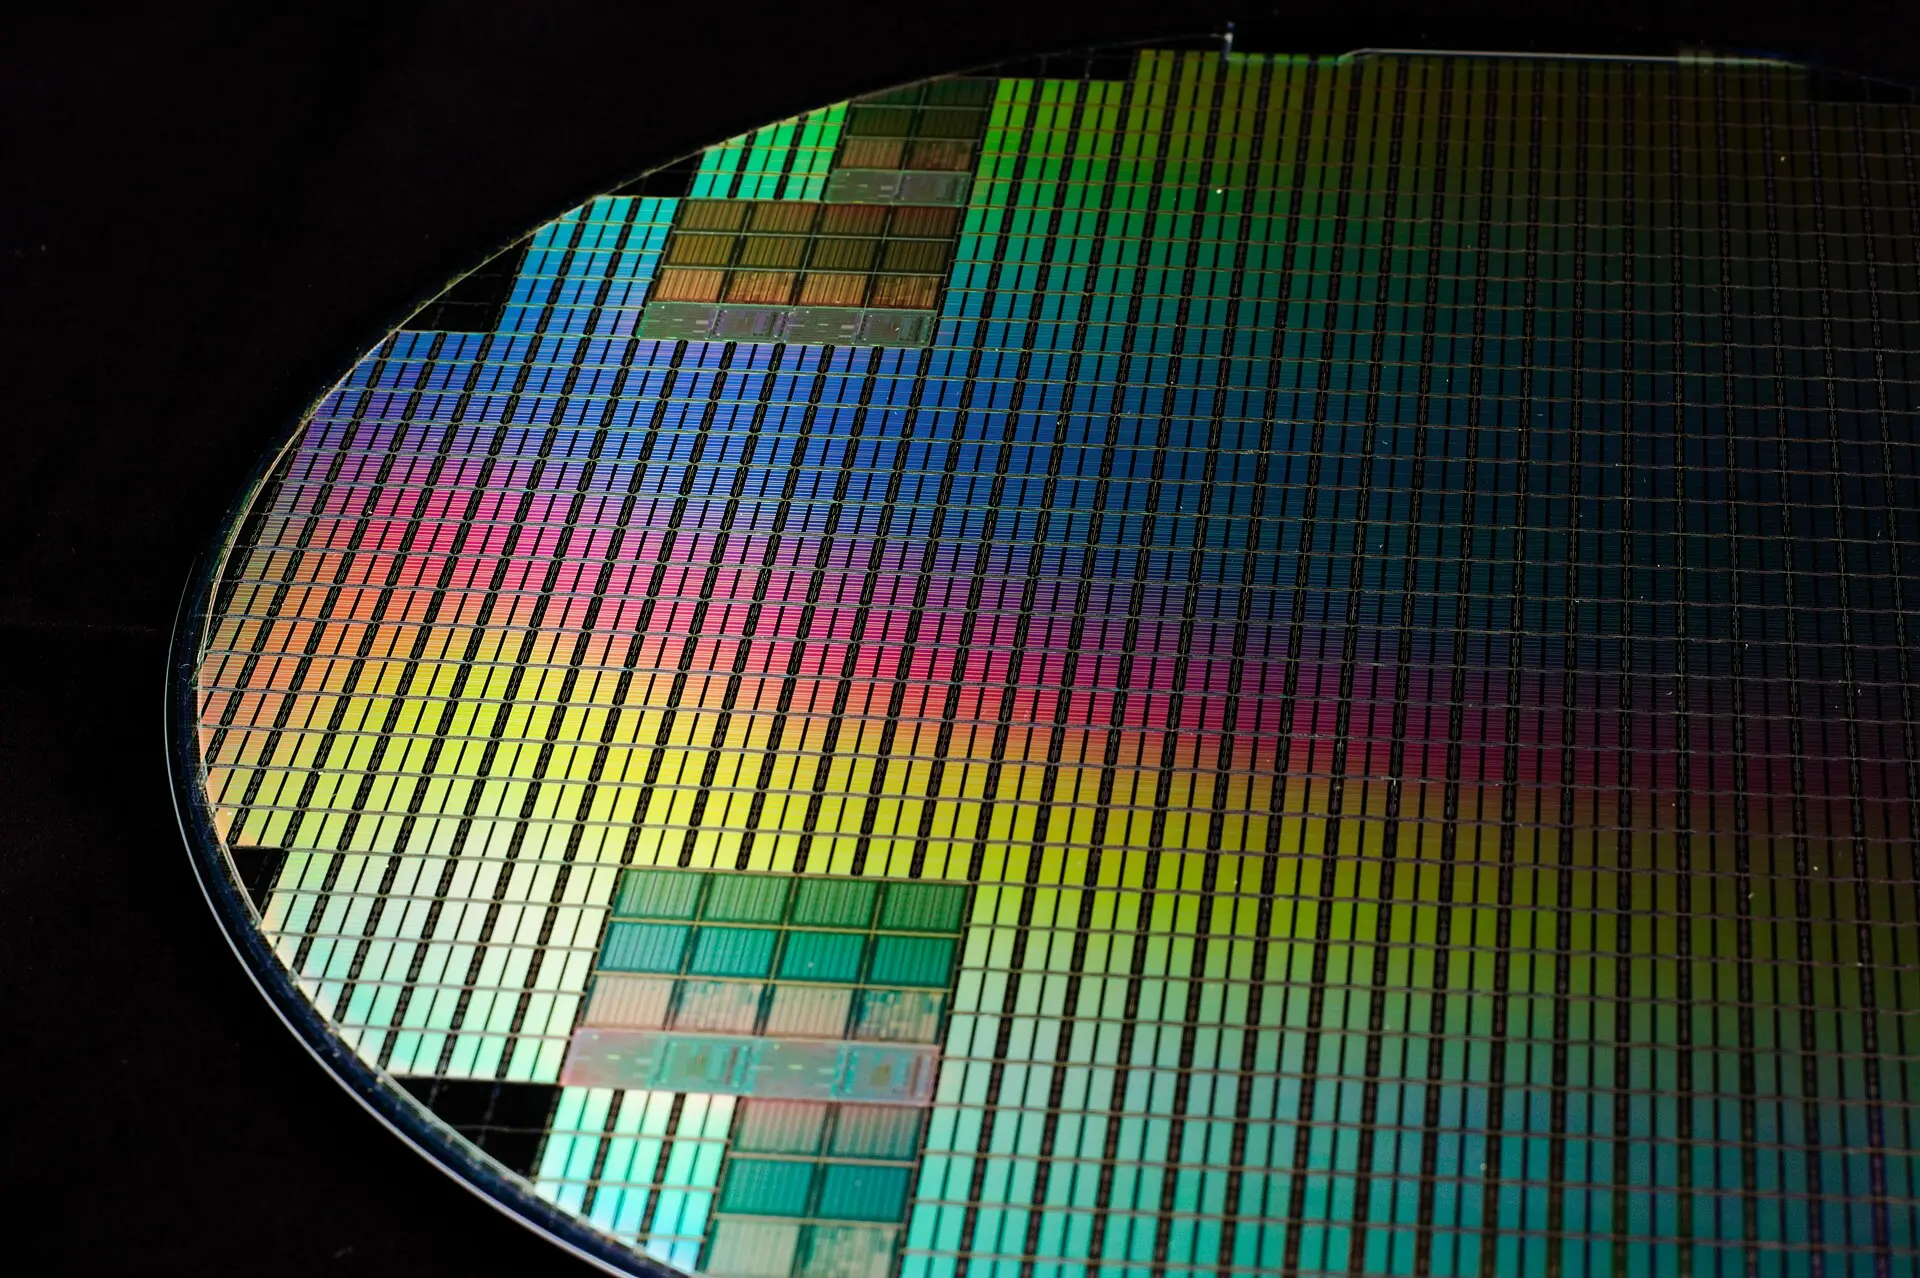
Compute-in-Memory reißt gerade diese Trennung ein. Rechenwerke wandern direkt in den Speicherbaustein, zwischen die Speicherzellen. Multiplikation und Addition passieren nun also dort, wo die Daten liegen. Lange Transportwege fallen teils weg, und mit ihm Zeit, Strom und Abwärme. Intern liegt die Bandbreite um ein Vielfaches höher als auf dem Weg nach draußen.
Eine Flash-Zelle hält nie wirklich digitale Werte, sie hält Ladung, und eine TLC-Zelle mit 8 unterscheidbaren Spannungsstufen misst im Grunde wie ein winziges analoges Multimeter. Schreibt man nun digitale Daten analog in Zellen, die bereits KI-Gewichte enthalten, und liest das Ergebnis als Spannung zurück, ist ein zentraler Schritt des Machine Learning, die Matrixmultiplikation, analog erledigt, bei Leistungsaufnahme im Mikrowattbereich. Erste Einsätze sind Mikrofonfilter, die Sprache vom Hintergrundrauschen trennen. Als Nächstes kommen Objekterkennungen in Kameras, wieder mit winzigen Datenraten, für die NOR-Flash reicht.
Die Idee ist alles andere als neu. Ansätze reichen Jahrzehnte zurück, vom Memristor als vermeintlich fehlendem vierten Bauelement bis zu spezialisierten Mustererkennungs-Chips. Neu ist der Datenhunger. KI-Inferenz erzeugt zum ersten Mal einen massiven Bandbreiten- und Energiebedarf, den klassische Architekturen nur teuer stillen können. Die Speicherhersteller haben das längst verstanden. Samsung hat rechnende DRAM-Prototypen gezeigt und Speicher mit integrierten Rechenwerken im HBM-Stapel vorgeführt, SK hynix und Micron arbeiten an eigenen Ausprägungen. Was noch fehlt, ist die Software.
Was dies für uns konkret bedeutet
Dein Gerät wird zum Host für eigene Sprachmodelle. Aktuelle Mobilchips führen heute schon LLM´s mit Milliarden Parametern dank Quantisierung lokal aus. Mit der Bandbreite aus dem Speicher werden Modelle auf dem Gerät praktikabel, mit Reaktionszeiten unter 200 Millisekunden und ohne jede Verbindung zur Cloud. Die KI, die dich kennt, muss dein Gerät dann nie verlassen. Für Datensouveränität ist das die größte strukturelle Wende seit dem Smartphone.
Die Memory Wall fällt, und mit ihr bröckelt die Vorherrschaft der Grafikbeschleuniger. Inferenz wird von der Speicherbandbreite begrenzt, von der Rechenleistung kaum. Rechnet der Speicher demnächst selbst, erledigt ein großer Teil der Arbeit keine Farm aus teuren Rechenbeschleunigern mehr. Die Freiheitsfrage wird zur Hardwarefrage. Deine KI ist heute ein Mietverhältnis, du mietest Tokens von großen Cloud-Anbietern. Mit einem Speicher, der selbst rechnet, wird KI ein Besitz, wie ein Auto statt eines Taxis.
Dazu kommen Geräteklassen, die es so noch nicht gibt. Wo heute Sensoren, Wearables, Maschinen und Hörgeräten am Akku scheitern, fällt der Energiehunger des Datentransports weg. Dann wird KI dort möglich, wo heute ein Netzteil Pflicht ist. Compute-in-Memory ist ein Edge-Thema, und genau dort entscheidet sich die Frage, wem die KI gehört.
Die Grenzen der Zeit
Damit die Rechenwerke im Speicher etwas nützen, müssen Betriebssystem, Compiler und KI-Frameworks wissen, dass dort Recheneinheiten sitzen. Kaum aus der Nische befreit, entscheidet nun der Software-Stack über die eigentliche Markthürde. Das ist das frühe Schicksal einer Technologie, die technisch bereit ist und vom jetzigem Zustand auf ihre Werkzeuge wartet.
Genau deshalb werden Staaten das Thema genau beobachten. Ein Rechenzentrum ist immer auch eine zentrale Abhörposition. Die Überwachung von heute lebt davon, dass Datenströme an wenigen Orten zusammenlaufen. Rechenleistung, die in die Geräte wandert, löst diese Zentralität auf. KI als Privateigentum passt nicht in dieses Bild, und Privateigentum ist genau das, was der Staat am liebsten reguliert.
Grafikbeschleuniger haben 2012 mit Deep Learning und ImageNet den heutigen Hype erst möglich gemacht. Compute-in-Memory könnte die zweite Welle zünden, eine, in der KI aufhört, ein Online-Dienst zu sein, und zu einer Eigenschaft des Geräts wird. Der Umbruch beginnt bei der Inferenz, also beim Ausführen fertiger Modelle.
Die nüchterne Zeitschiene: Bis 2028 erscheinen digitale Lösungen in spezialisierten Nischen, in der Cloud und am Edge, sobald Compiler und Werkzeuge reifen. Danach kommen analoge Chips mit Massenpotenzial, vorher sind sie zu ungenau und zu teuer in der Fertigung. Bis mindestens 2030 bleiben die klassischen Beschleuniger dominierend. Compute-in-Memory ergänzt, es ersetzt nicht.
Fazit
Wer ein fertiges Modell für seinen Agenten ausführen will, bekommt bald Hardware, die mit einem Bruchteil der Energie von heute auskommt. Der Stromaufwand der heute für das Hin und Her der Daten verbrannt wird, wird anderswo genutzt.